



Ciao a tutti,
nell’articolo di oggi voglio parlarvi di un nuovo strumento che ho scoperto per ottimizzare l’utilizzo di Claude Code (ma anche Opencode o Codex): si chiama ColGrep-Agent-2B, un agente locale sviluppato da LightOn AI che serve a ridurre il consumo di token durante la fase di localizzazione del codice. Il modello è abbastanza piccolo per essere utilizzato in locale!
Se usate Claude Code, saprete che ogni volta che l’agente deve cercare un file o una funzione, l’intero contesto accumulato viene rimandato al modello di frontiera. Questo non solo aumenta i costi se utilizziamo le API, ma può portare a saturare più velocemente il contesto. L’idea di ColGrep è semplice: spostare la ricerca semantica in locale, in modo tale che Claude (o chi per esso) riceva solamente i percorsi ed i rami esatti di cui ha bisogno.
Scendiamo ora più nel dettaglio e cerchiamo di capire come funziona e come utilizzarlo
Come funziona ColGrep-Agent-2B
A differenza di un semplice grep o find, ColGrep non si limita a cercare stringhe di testo, ma utilizza la ricerca semantica. Il cuore del sistema è un motore multi-vettore chiamato NextPlaid ed un modello di linguaggio specializzato di soli 2 miliardi di parametri.
In pratica, il sistema va a estrarre funzioni, metodi e classi tramite Tree-sitter e calcola degli embedding direttamente su CPU. Quando poniamo una domanda all’agente, ColGrep analizza il significato della richiesta e restituisce al coding agent i file e gli intervalli di righe più pertinenti nel formato path:START-END.
Il vantaggio è enorme: il codice non lascia mai la vostra macchina ed l’agente di frontiera non deve “sprecare” token per navigare a tentoni tra le cartelle del progetto.
Setup e installazione
Configurare ColGrep sul proprio PC è piuttosto rapido. Se siete su macOS, possiamo usare Homebrew per installare tutto in un colpo solo:
brew install lightonai/tap/colgrep && colgrep --install-agentPer chi invece utilizza Windows o Linux, l’installazione può essere effettuata tramite script shell, PowerShell oppure, per chi ha Rust installato, via cargo install colgrep && colgrep --install-agent.
Da notare che, mentre su macOS l’inferenza è ottimizzata con Accelerate e CoreML, su Linux e Windows l’esecuzione avviene solamente su CPU (a meno di non compilare il tool da sorgente attivando le features CUDA per utilizzare la GPU).
Il comando --install-agent si occupa di scaricare il modello GGUF. A seconda della memoria RAM che vogliamo dedicare al processo, possiamo scegliere tra diverse quantizzazioni:
- Q4_0: circa 1,49 GB
- Q4_K_M: 1,56 GB
- Q5_K_M: 1,81 GB
- Q6_K: 2,07 GB
- Q8_0: 2,68 GB (versione di default)
- F16/BF16: 5,04 GB
Una volta installato, dobbiamo indicizzare il nostro progetto per permettere all’agente di lavorare correttamente:
colgrep init /percorso/al/vostro/progettoDa notare che l’indice viene aggiornato in modo incrementale dopo ogni ricerca, quindi non c’è bisogno di rifarlo ogni volta che modificate un file.
Integrazione con Claude Code e altri agenti (OpenCode o Codex)
Il vero punto di forza è l’integrazione con Claude Code. Per abilitarla, basta eseguire il comando:
colgrep --install-claude-codeQuesto comando installa degli hook di sessione che suggeriscono a Claude di utilizzare ColGrep invece dei classici comandi di ricerca. Una volta riavviato Claude Code, l’integrazione sarà attiva.
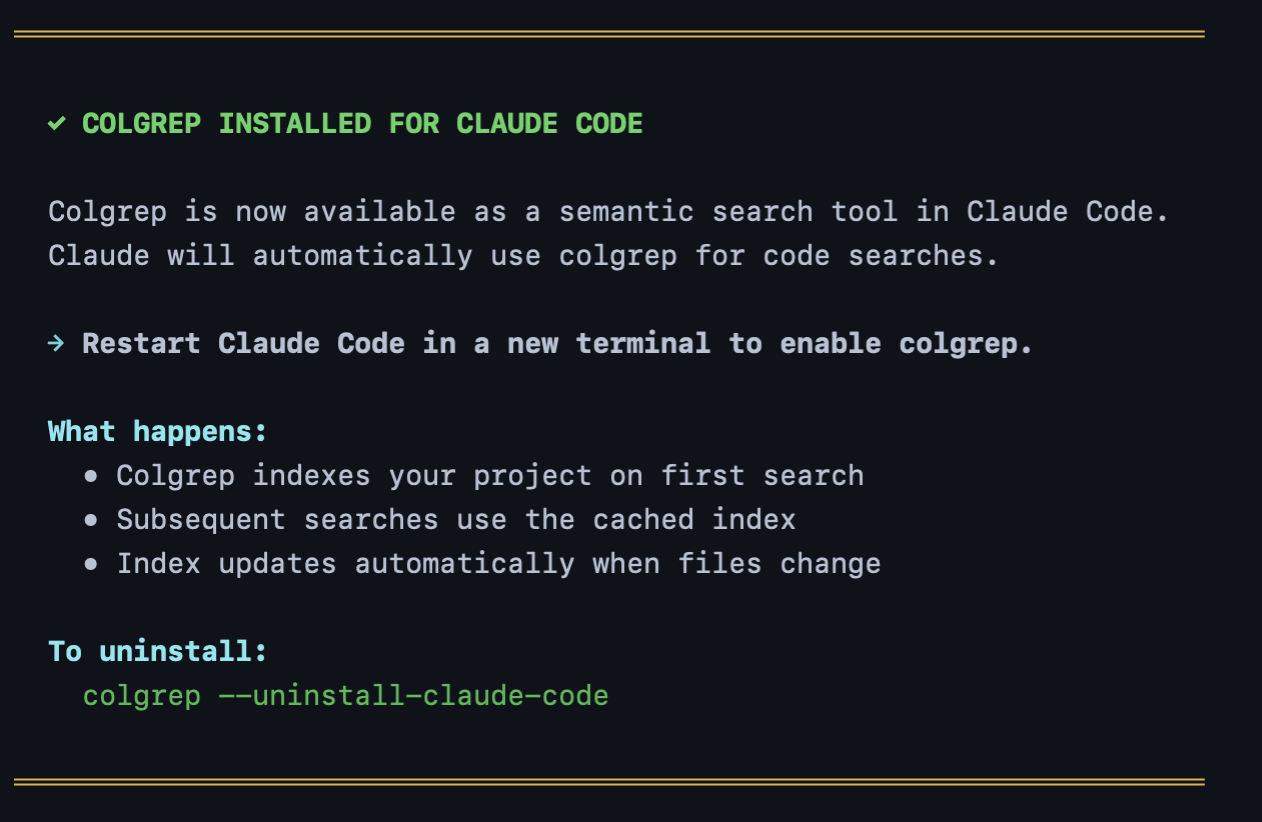
Se invece utilizzate altri agenti come Opencode, Codex o Hermes, potete installare l’integrazione usando i rispettivi comandi (--install-opencode, --install-codex o --install-hermes). In questo caso però l’integrazione è più basilare: non avrete il supporto completo agli hook che invece è presente per Claude Code.
Possiamo anche scegliere come l’agente deve comportarsi tramite il comando colgrep settings --hook-mode. Abbiamo tre opzioni:
hybrid(default): usa ColGrep per nomi e pattern, ed l’agente semantico per domande più complesse.agent: suggerisce sempre l’uso dicolgrep --agent, massimizzando il risparmio di token.colgrep: disattiva l’agente semantico e usa solo la ricerca basata su indici.
I numeri: quanto si risparmia davvero?
I dati forniti da LightOn AI sono molto interessanti. In un test condotto su 13 repository (con dimensioni che arrivano fino a 1,8 milioni di righe) utilizzando Claude Sonnet 5.5, i risultati mostrano un netto vantaggio in termini di costi.
Risparmio di token: l’uso di ColGrep-Agent ha permesso di ridurre i token per domanda da 142k (con grep standard) a 93k, con un risparmio medio del 34,3%.
In termini di costi, parliamo di scendere da circa 7,3¢ a 4,4¢ per domanda. Se lavorate su progetti enormi, il risparmio diventa ancora più evidente: su repository sopra il milione di righe, l’efficienza aumenta fino al 46%.
C’è però un compromesso: la latenza. Tendenzialmente grep è molto più veloce mentre l’inferenza del modello locale richiede tempo (in alcuni casi anche 20 secondi su un M3 Pro).
Conclusioni
Man mano che il tempo passa i modelli locali stanno diventando sempre più affidabili e sempre più piccoli, consentendoci di poterli utilizzare davvero anche senza possedere un DGX Spark o chissà quale hardware, a velocità ragionevoli.
Nell’esempio di oggi abbiamo visto questo piccolo modello in grado di aiutarci: non è la soluzione a tutti i problemi, ma io lo considero come uno “strumento” nella nostra cassetta degli attrezzi, un qualcosa da utilizzare strategicamente per aiutarci nell’abbattere il consumo dei token.
Alla prossima!


